


食物不足发生率
定义:食物不足被定义为个人习惯性的食物摄入量平均下来不足以提供健康、活跃和正常生活所需的膳食能量。
报告方式:“食物不足发生率”(简称PoU)估算了整个人口中处于食物不足状态者所占百分比。国家估计值以三年移动平均值的形式呈现,以控制一些可靠性较低的基础参数估计值。因为这些估计值,包括粮农组织食物平衡表(FBS)组成部分之一的食物商品库存年度变化等,缺乏完整可靠的信息。而区域和全球汇总数据则以年度估计值呈现,鉴于可能存在的估计值误差预计不具关联性,因此,将各国数据汇总时,预计估计值误差会降低到可接受水平。
每次发布本报告时,都会根据粮农组织获得的最新数据和信息,修订食物不足发生率的系列估计值。由于这个过程通常意味着对食物不足发生率全部数值进行回溯性修订,建议读者不要比较本报告不同版本的估计值,而应始终参考本报告当前版本,包括查阅往年的估计值。
计算方法:要估算特定人群的食物不足发生率,需要将每天人均习惯性膳食能量摄入水平(以千卡为单位)的概率分布建模为参数概率密度函数f(x)。1, 2该指标是指习惯性膳食能量摄入(x)低于最低膳食能量需求(MDER,即适合该人群代表性个体能量需求范围的下限)的概率,如以下公式所示:

其中θ是描述概率密度函数的参数向量。在实际计算中,假定分布是对数正态分布,因此,全面描述只需两个参数:平均膳食能量消费(DEC)及其变异系数(CV)。
数据来源:使用了不同数据来源来估算模型的不同参数。
最低膳食能量需求 (MDER):以每千克体重基础代谢率的标准需求,乘以该性别/年龄组在特定身高时应具有的理想体重,然后乘以体力活动水平系数(PAL),来确定个人的能量需求。bl由于健康体重指数(BMI)和正常PAL在同一性别和年龄组的健康活跃个体中存在差异,因此每个性别和年龄组都有一个能量需求范围。用该性别和年龄组人口占比作为权重,计算出用于PoU公式的个体平均最低膳食能量需求。类似地,用“活跃或中度活跃生活方式”的平均PAL值,估算平均膳食能量需求(ADER) (用于估算后文所述CV的一个组成部分)。4
对于世界上大多数国家来说,计算最低膳食能量需求所需的按性别和年龄分类的年度人口结构信息,可参考联合国经济和社会事务部编写的《世界人口展望》,该报告每两年修订一次。本期《世界粮食安全和营养状况》使用的是2022年版《世界人口展望》。5
各国不同性别和年龄组的中位身高信息来自最近的人口与健康调查(DHS)或其他收集人体测量数据的调查。即使这些调查的年份与估算PoU的年份不同,但身高的小幅变化对MDER及由此对PoU估算的影响可忽略不计。
膳食能量消费 (DEC):理想情况下,DEC可从国家具有代表性的家庭调查(如生活水平测量研究[LSMS]或家庭消费支出调查)中获得,但只有少数国家每年进行此类调查。因此,在粮农组织用于全球监测的PoU估算中,DEC值源自粮农组织为大多数国家编制的食物平衡表(FBS)中的膳食能量供给(DES)信息。6
自上期报告发布以来,粮农组织统计数据库上的FBS数值已更新至2021年。此外,在本报告截稿时,有68个国家的FBS系列数值还更新至2022年。选取这些国家进行优先更新,是因为这些国家对全球食物不足人数贡献最大。相关国家包括:阿富汗、安哥拉、阿根廷、孟加拉国、贝宁、多民族玻利维亚国、巴西、布基纳法索、喀麦隆、中非共和国、乍得、哥伦比亚、刚果共和国、科特迪瓦、朝鲜民主主义人民共和国、刚果民主共和国、厄瓜多尔、埃及、埃塞俄比亚、加纳、危地马拉、几内亚、海地、洪都拉斯、印度、印度尼西亚、伊朗伊斯兰共和国、伊拉克、日本、约旦、肯尼亚、莱索托、利比里亚、马达加斯加、马拉维、马来西亚、马里、摩洛哥、莫桑比克、缅甸、尼泊尔、尼加拉瓜、尼日尔、尼日利亚、巴基斯坦、巴布亚新几内亚、秘鲁、菲律宾、卢旺达、沙特阿拉伯、塞内加尔、塞拉利昂、索马里、南非、南苏丹、斯里兰卡、苏丹、阿拉伯叙利亚共和国、泰国、多哥、乌干达、乌克兰、坦桑尼亚联合共和国、委内瑞拉玻利瓦尔共和国、越南、也门、赞比亚和津巴布韦。此外,另一组27个对全球食物不足人数贡献较小的国家,食物平衡表中的膳食能量供给系列估计值也更新至2022年,这些国家是:阿尔巴尼亚、亚美尼亚、巴哈马、波斯尼亚和黑塞哥维那、佛得角、智利、中国(大陆)、哥斯达黎加、吉布提、多米尼加共和国、萨尔瓦多、斯威士兰、牙买加、科威特、黎巴嫩、利比亚、毛里塔尼亚、蒙古、黑山、阿曼、巴拿马、巴拉圭、圣多美和普林西比、斯洛伐克、东帝汶、突尼斯和美利坚合众国。
对2022年(上述国家之外其他国家)人均DES的预测,以及对2023年(所有国家)人均DES的预测,基于粮农组织进行的短期市场展望。这些展望用于世界粮食形势门户网站,7并用于计算每个国家2022年和2023年的DEC值。
浪费系数
本报告更新了用于计算膳食能量消费(DEC)的浪费系数,办法是从各国膳食能量供给(DES)中减去浪费百分比。各国流通环节的食物浪费百分比根据粮农组织统计数据库上提供的食物平衡表数据估算。
根据粮农组织编写的《全球食物损失和食物浪费》8中给出的百分比,计算了每种食物类别的卡路里浪费数量,并进行了求和,但所有地区谷物的浪费系数均以2%计算。最后,卡路里浪费总量以每年每个国家卡路里总量的百分比表示,数据更新至2021年。2022年和2023年使用了与2021年相同的数值。
索马里和巴勒斯坦缺少鱼类消费数据,因此,仅估算了鱼类外其他食物的浪费系数。危地马拉和多明尼加共和国没有数据更新。
变异系数(CV):人口中习惯性膳食能量消费(DEC)的变异系数(CV)被视为两个成分的几何平均值,这两个成分分别标记为CV|y和CV|r:
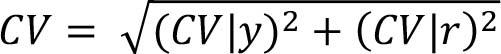
第一个成分(CV|y)指的是不同社会人口分层间人均消费的差异,因此被称为“缘于收入”的变异系数;第二个成分(CV|r)则代表由于性别、年龄、体重和体力活动水平(PAL)的差异而在同一家庭成员间出现的差异。因为这些因素都是决定能量需求的因素,所以第二个成分被称为由“缘于能量需求”的变异系数。
CV|y
如存在可靠的国家代表性家庭调查数据,可以直接估算缘于收入的变异系数(CV|y)。自上一期报告发布以来,为更新CV|y共整理了来自以下13个国家的14项最新调查:亚美尼亚(2022年)、哥斯达黎加(2019年)、科特迪瓦(2022年)、印度(2011-12年以及2022-23年)、约旦(2017年)、哈萨克斯坦(2022年)、马尔代夫(2016年)、马里(2022年)、墨西哥(2022年)、尼日尔(2022年)、摩尔多瓦共和国(2022年)、塞内加尔(2022年)、东帝汶(2015年)。这样,基于国家调查数据的CV|y估算共包括69个国家的143项调查。
如果没有合适的调查数据可用,就用粮农组织自2014年以来收集的粮食不安全体验分级表(FIES)数据,根据观察到的重度粮食不安全趋势,预测2015年(或之后最近一次粮食消费调查年份)至2023年的CV|y变化。这种预测是基于如下假设,即使用FIES测量的重度粮食不安全程度的变化可能反映了PoU的同等变化。如果这种PoU的隐含变化不能完全由平均食物供给量的“供给侧”效应来解释,那么这种变化就可以放心地归因于在同一时期可能发生的未观察到的CV|y变化。对历史PoU估计值的分析表明,平均而言,在控制了DEC、MDER和CV|r的差异之后,CV|y的差异能够解释PoU时空差异的大约三分之一。基于此,对于每个有FIES数据的国家,从2015年或此后最近一次调查日期起可能发生的CV|y变化,都被估计为重度粮食不安全发生率每发生一个百分点的变化,都会产生三分之一个百分点的PoU变化。对于所有其他国家,由于缺乏任何支持性证据,CV|y保持在最近一次估计值不变。与前两期报告一样,2020年、2021年、2022年和2023年的CV|y预测需要特殊处理,以考虑COVID-19疫情的影响(见第2章补充材料)。
CV|r
缘于能量需求的变异系数(CV|r表)示一个健康人群中代表性个体膳食能量需求分布的差异,等同于如果该人群完全营养均衡,每个“平均个体”的膳食能量摄入分布差异。为了估算,我们假设这个“平均个体”的膳食能量需求分布是正态的,其标准差(SD)可以通过已知的任意两个百分位点来推算。我们使用前述的MDER和ADER来估算1%和50%的百分位点。9, 10然后通过逆累积标准正态分布得到CV|r的值。
挑战和局限性:虽然食物不足是适用于个体的状况,但由于数据是大规模采集的,很难准确识别哪些个体实际处于食物不足状态。通过上述统计模型,只能针对整个人群或具有足够代表性的样本计算这个指标。因此,食物不足发生率只能推算为处于食物不足状态的个体占整个人群的百分比,而无法进一步细化到个体。
由于推导的盖然性以及模型参数推算的不确定性,食物不足的估计发生率通常不够精确。虽然无法正式计算误差区间,但通常会超过5%。因此,粮农组织不会将低于2.5%的估计值视为可靠数据。
需要注意的是,2020-2023年食物不足发生率区间并不是统计意义上的置信区间,而是用于预测2020-2023年CV|y值的不同情景。
推荐阅读:
FAO. 1996. Methodology for assessing food inadequacy in developing countries. In: The Sixth World Food Survey, pp. 114–143. Rome. https://www.fao.org/4/w0931e/w0931e16.pdf
FAO. 2003. Proceedings: Measurement and Assessment of Food Deprivation and Undernutrition: International Scientific Symposium. Rome.
FAO. 2014. Advances in hunger measurement: traditional FAO methods and recent innovations. FAO Statistics Division Working Paper, No. 14–04. Rome.
Naiken, L. 2002. Keynote paper: FAO methodology for estimating the prevalence of undernourishment. Paper presented at the Measurement and Assessment of Food Deprivation and Undernutrition International Scientific Symposium, Rome, 26–28 June 2002. Rome, FAO.
Wanner, N., Cafiero, C., Troubat, N. & Conforti, P. 2014. Refinements to the FAO methodology for estimating the prevalence of undernourishment indicator. Rome, FAO.
以粮食不安全体验分级表衡量的粮食不安全发生率
定义:通过这一指标衡量的粮食不安全状况是指,由于缺乏金钱或其他资源,个人或家庭对食物的获取受到限制。粮食不安全的严重程度,通过使用粮食不安全体验分级表调查模块(FIES-SM)收集的数据来衡量,该模块是一组八个问题的问卷,要求受访者自我报告通常与获取食物受限相关的状况和体验。为了监测年度可持续发展目标实现情况,这些问题要求回答调查前12个月的体验。
利用基于Rasch模型的复杂统计技术,FIES-SM调查所获得的信息经过内部一致性验证,量化为从低到高的严重程度分级。根据个体对调查项目的回答,在全国性人口调查中接受询问的个人或家庭按概率被分配到三个类别之一:(一)粮食安全或仅轻微不安全;(二)中度粮食不安全;(三)重度粮食不安全;三个类别由两个全球设定的阈值界定。根据2014年至2016年三年收集的FIES数据,粮农组织建立了粮食不安全体验分级表,用作基于经验的粮食不安全度量全球标准,并用于设定严重程度的两个参考阈值。
通过累加中度和重度两级粮食不安全概率,可获得可持续发展目标指标2.1.2的实现情况。而重度粮食不安全指标(FIsev),则仅通过计算重度粮食不安全一个级别获得。
报告方式:在本期报告中,粮农组织估计了粮食不安全发生率的两个级别:中度或重度粮食不安全(FImod+sev),以及重度粮食不安全(FIsev)。对于这两个级别,分别报告了两个估计值:
- 在至少有一个成年人粮食不安全的家庭中生活的个体所占比例;
- 在至少有一个成年人粮食不安全的家庭中生活的估计个体数量。
数据来源:自2014年以来,FIES-SM问卷的八个问题已应用于盖洛普©世界民意调查(GWP)中包括的140多个国家具有代表性的成年人口样本(定义为15岁或以上),覆盖了世界90%以上的人口。2023年,通过电话和面对面方式进行了访谈。鉴于在COVID-19疫情期间当面进行数据收集存在社区传播的较大风险,一些国家2020年采用了电话访谈,而2023年也维持了这种方式。
盖洛普©传统上在北美洲、西欧、亚洲部分地区以及海湾阿拉伯国家合作委员会成员国使用电话调查。在中欧和东欧、拉丁美洲的大部分地区,以及亚洲、近东和非洲几乎所有地区,通过区域框架设计进行抽样,然后进行面对面访谈。
在大多数国家,样本包括大约1000名个体。印度的样本量更大,为3000人;中国(大陆)为3500人;俄罗斯联邦为2000人。2023年,没有在中国(大陆)收集数据。
利用官方调查数据估算了至少70个国家的粮食不安全发生率,覆盖了世界人口的四分之一以上。这些数据通过粮农组织的统计方法进行内部验证,并将各国的调查结果调整到同一全球参考标准。这些数据一旦得到验证,就用于更新国家系列估计值或作为更新参考(见下文所述)。当一个国家的人口占区域人口的很大一部分时,这可能导致区域和次区域系列估计值的修订或回溯修订。因此,应避免比较不同年份报告中的估计值,而应将本期报告视为标准。
在本报告中,使用了以下70个国家的官方调查数据:阿富汗、安哥拉、亚美尼亚、伯利兹、贝宁、博茨瓦纳、巴西、布基纳法索、布隆迪、佛得角、加拿大、乍得、智利、哥伦比亚、刚果、哥斯达黎加、科特迪瓦、多米尼加共和国、厄瓜多尔、斐济、加纳、希腊、格林纳达、几内亚比绍、圭亚那、洪都拉斯、印度尼西亚、以色列、哈萨克斯坦、肯尼亚、基里巴斯、吉尔吉斯斯坦、莱索托、马拉维、马里、墨西哥、莫桑比克、纳米比亚、尼日尔、尼日利亚、巴基斯坦、巴勒斯坦、巴布亚新几内亚、巴拉圭、菲律宾、大韩民国、俄罗斯联邦、圣基茨和尼维斯、圣卢西亚、圣文森特和格林纳丁斯、萨摩亚、塞内加尔、塞舌尔、塞拉利昂、南非、南苏丹、斯里兰卡、苏丹、东帝汶、汤加、乌干达、阿拉伯联合酋长国、坦桑尼亚联合共和国、美利坚合众国、乌拉圭、瓦努阿图、越南、也门和赞比亚。如果一些年份缺乏数据,则遵循以下方法:
- 如存在超过一年的官方数据,则缺失年份通过线性插值计算。
- 如果只有一年的数据,则缺失年份以如下方式补充:
- –如果粮农组织数据与国家调查兼容,则使用粮农组织数据;
- –如果粮农组织数据与国家数据不兼容,则使用粮农组织数据呈现的趋势进行估算;
- –如果没有其他可靠和及时的信息,则使用次区域趋势进行估算;
- –如果次区域趋势无法估算,或其他调查的趋势或次区域的趋势不适用于特定国家(考虑到该趋势的证据支持,如贫困、极端贫困、就业和食品通货膨胀的变化等),则认为缺失年份的数据与现有官方调查水平相同;这同样适用于粮食不安全发生率非常低(重度水平低于3%)或非常高(中度或重度水平高于85%)的国家。
鉴于调查资料来源的异质性,且一些粮农组织调查的样本量较小,新数据偶尔会导致年份之间的显著增加或减少。在这种情况下,解决方法是寻找该国之外的信息(数据和/或报告,可能与粮农组织国家或区域官员协商),以探讨是否发生了重大冲击或干预。如果趋势可以通过证据得到支持,但看起来仍过于夸张,则维持该趋势但使之平滑(例如,使用三年平均值)。否则采用与缺失年份相同的办法(即保持水平不变或应用次区域趋势)。2023年,中国(大陆)没有收集FIES数据,因此趋势保持不变。
计算方法:数据经过验证,并用于通过Rasch模型构建粮食不安全严重程度量表。该模型假设受访者i 对问题j给出肯定回答(Yes)的概率是受访者在严重程度量表上的位置ai与问题的位置bj之间的距离的逻辑函数。
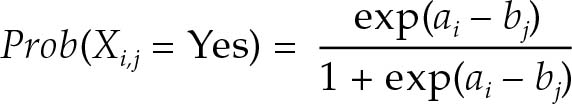
通过在Rasch模型中应用FIES数据,可以估计在每种粮食不安全严重程度L(中度或重度,或仅重度)下,每个受访者i粮食不安全的概率(pi,L),0 <pi,L<1。
在每种严重程度L下,人口中粮食不安全发生率(FIL)是所有样本中受访者(i)粮食不安全概率的加权和:
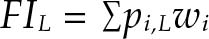
其中wi是后分层抽样权重,表示每个样本记录在国家人口中代表的个体或家庭的比例。
由于盖洛普©世界民意调查(GWP)中仅对15岁或以上的个体进行抽样,因此直接从这些数据产生的粮食不安全发生率估计值指的是15岁及以上的人口。要得出所有年龄段个体在人口中的粮食不安全发生率和数量,需要估计在至少有一个成年人被估计为粮食不安全的家庭中生活的个体的数量。这涉及到一个多步骤程序,该程序详见《估算世界各地成年人粮食不安全发生率的方法》附件二(见下文“推荐阅读”部分中的链接)。
中度或重度以及严重粮食不安全的区域和全球汇总FIL,r计算如下:

其中r表示区域,FIL,c是该区域中的国家c在严重程度L的FI估计值,Nc是相应的人口规模。当一国没有FIL的估计值时,相关估计值被假定等于同一次区域中剩余国家估计值的人口加权平均值。只有在有估计值的国家至少覆盖该区域50%的人口时,才会计算区域加 总值。
全球统一阈值根据FIES全球标准量表(基于2014-2016年GWP调查所覆盖国家的调查结果的一套项目参数值)加以定义,并转换为本地量表上的相应值。将每个国家量表与FIES全球标准校准的过程,可以称为等同化,这样做可以生成国际可比的个体受访者粮食不安全严重程度的度量值,以及可比较的各国粮食不安全发生率。
以上问题源于这样的事实:当粮食不安全的严重程度被定义为潜在特质时,没有绝对参照物可以用来比较评估。Rasch模型能够识别各种项目在量尺上所占据的相对位置。该量尺以logit单位命名,但其“零点”是任意设定的,通常对应于估计严重程度的平均值。这意味着每次应用时量尺的零点都会改变。为了在不同时间和不同人群中产生可比的度量,需要建立一个共同的量尺作为参照,并找到将度量结果在不同量尺之间转换的公式。就像在不同量尺(如摄氏度和华氏度)之间转换温度一样,需要确定一些“锚点”。在FIES计算方法中,这些锚点是与全球参考量尺上相应项目相对位置相当的严重程度。然后,需要找到一个公式,将一个量尺的度量结果“映射”到另一个量尺,即将共同项目严重水平的平均值和标准差画上 等号。
挑战和限制:GWP调查收集FIES数据时,大多数国家的全国样本量约为1000名个体。基于这些数据估计粮食不安全发生率,置信区间很少超过被测量发生率的20%(即50%的发生率将有高达正负5%的误差范围)。然而,如果使用较大样本估计发生率,或者利用几个国家的累加数据进行估计,置信区间会小得多。为了减少年度抽样差异的影响,国家层面的估计以三年平均值呈现,按照相关三年中所有可用年份的平均值计算。
国家的官方调查是基于FIES估计粮食不安全发生率的首选参考。然而,这些调查可能不是每年进行,且数据可能在几年后才能提供给粮农组织。在没有年度国家调查的情况下,就使用前文方法(见“数据来源”)来推断系列各年度的系列估计值,这可能导致系列估计值的回溯修订。
推荐阅读:
FAO. 2016. Methods for estimating comparable rates of food insecurity experienced by adults throughout the world. Rome. https://openknowledge.fao.org/handle/20.500.14283/i4830e
FAO. 2018. Voices of the Hungry. In: FAO. [Cited 28 April 2020]. https://www.fao.org/in-action/voices-of-the-hungry
Cafiero, C., Viviani, S. & Nord, M. 2018. Food security measurement in a global context: The food insecurity experience scale. Measurement, 116: 146–152. [Cited 25 June 2024].
https://www.sciencedirect.com/science/article/pii/S0263224117307005
健康膳食的成本
定义:健康膳食的成本定义为购买最便宜、当地可得食物的成本,这些食物可以组成一份食谱,满足能量平衡设定在每天2330千卡的参考人的能量需求和食源性膳食指南的要求。
报告方式:“健康膳食成本”(CoHD)是一个估计值,表明人们在一国最低必须平均花费多少成本,才能买到组成健康膳食所需的最便宜、当地可得食物。为了具有跨国可比性,我们使用私人消费购买力平价(PPP)汇率,将健康膳食的成本从当地货币单位转换为国际美元,因此,CoHD指标以每天人均购买力平价美元呈现。
数据来源:健康膳食所需的每个食物组别中食品的价格来自世界银行协调的国际比较计划(ICP)的零售食品价格数据,该计划根据以当地货币单位(LCU)计价的一系列国际标准化食品估算购买力平价。11这些价格由每个国家的官方统计机构与ICP全球办公室协调进行报告,代表全年各市场的平均成本。为了进行国际比较,我们使用ICP计算并在世界发展指标(WDI)数据库中报告的私人消费购买力平价转换因子,把当地货币价格转换为国际美元。12如果某年份在ICP调查周期中没有数据,更新健康膳食成本时使用粮农组织发布的食品消费价格指数(CPI)数据。13
计算方法:
定义健康膳食篮(HDB)的方法
鉴于健康膳食中选择的食物因当地背景而异,各国纷纷制定了本国的食源性膳食指南(FBDG),以推荐反映其文化背景和当地可得食物的健康膳食习惯。然而,并非所有国家都有膳食指南,而且有膳食指南的国家通常缺乏关于食物数量和能量的量化建议。为了解决这一数据限制,并创建一个反映全世界膳食指南共性的全球健康膳食标准,本报告选择了最近几年编制的代表世界不同地区的十个量化膳食指南,通过创建健康膳食篮来设定这一全球标准。健康膳食篮基于各国膳食指南中不同食物组比例的平均值,使用了十个量化膳食指南中推荐食物组食物数量的中位数。健康膳食篮旨在满足每天2330千卡的膳食能量摄入,由六类当地可得食物组成:淀粉类主粮;蔬菜;水果;动物源性食品;豆类、坚果和种子;油和脂肪。具体来说,健康膳食篮旨在提供:1160千卡的淀粉类主粮;110千卡的蔬菜;160千卡的水果;300千卡的动物源性食品;300千卡的豆类、坚果和种子;300千卡的油和脂肪。2017年至2022年,对169个国家的健康膳食成本进行了估算。
有ICP数据时的成本计算方法
为了计算最经济的健康膳食,在每个时间和地点,每个ICP食品项目都被归入其食物组别,并指出满足健康膳食篮(HDB)要求的最便宜食品项目。对于每个国家,在HDB中总共选择了11种最经济的食品项目:淀粉类主粮2种;蔬菜3种;水果2种;动物源性食品2种;豆类、坚果和种子1种;油和脂肪1种。每个食物组每天的成本计算方法,是该组中选定食品项目的价格乘以一个食品量,该食品量需包含HDB为该组规定的能量含量。最后,通过汇总六个食物组的成本,确定了每个国家的健康膳食成本。
无ICP数据时的成本更新方法
目前仅有ICP计划可以提供国际标准化食品项目零售价格数据,而这些数据每三到四年才更新一次,无法据此每年更新健康膳食成本。最近的ICP系列数据于2024年发布,涉及2021年的价格。为了在ICP计划没有涉及的年份更新成本指标,我们将粮农组织发布的食品类CPI数据集应用于2021年的健康膳食成本,以估计ICP周期未涉及年份的成本。粮农组织数据集跟踪各国每月一般性和食品类CPI数据的变化,以2015年为基年。年度CPI数据是一年内12个月CPI数据的简单平均值。我们将每个国家2021年的实际成本(以当地货币单位LCU表示)乘以食品消费价格指数(FCPI)比值,最后除以PPP,以此估算缺失年份的健康膳食成本,即:

其中:

和

对于缺少PPP数据的国家,使用带外部解释变量的自回归积分滑动平均模型(ARIMAX)进行PPP估算。根据世界银行WDI计算方法对PPP进行外推,将一个国家的一般性CPI数据与基准国(在本文情况下即美利坚合众国)CPI数据之间的比值作为PPP值的关键预测因素纳入模型规格。此外,人均国内生产总值(GDP)和人均家庭消费支出也作为外部协变量添加,如果需要,对这两个系列都应用Holt-Winter平滑方法来填补空白。ARIMAX方法允许我们为每个国家/地区设定几种模型结构,包括自回归部分、积分部分、移动平均部分和三者的组合。当至少CPI比值的估计系数在统计上显著时,选择出最佳模型结构,其次是依赖ARIMAX参数的统计显著性进行选择。对于随时间显示异常PPP系列数值的国家/地区,我们发现CPI比值是影响PPP数值变化的唯一统计显著系数。相反,对于PPP系列数值不太波动的国家/地区,历史PPP趋势以及人均GDP和/或人均支出的估计系数也在预测PPP数值方面发挥作用。ARIMAX为每个国家/地区计算出所选最佳模型结构的预测值。
挑战和限制:缺乏国际标准化食品价格的年度数据,无法进行年度监测。更新健康膳食成本的方法有一个限制,即成本的变化取决于食品的CPI数据,且不反映具体食品项目价格的变化,也不反映不同食物组别价格的差异性变 化。bm粮农组织正在与世界银行合作,探索如何扩大食品项目级价格的报告,以便更频繁、更稳健地监测健康膳食的成本。
健康膳食成本的区域和全球汇总以每个组别中每个国家的算术平均值计算。
推荐阅读:
Herforth, A., Bai, Y., Venkat, A., Mahrt, K., Ebel, A. & Masters, W.A. 2020. Cost and affordability of healthy diets across and within countries. Background paper for The State of Food Security and Nutrition in the World 2020. FAO Agricultural Development Economics Technical Study, No. 9. Rome, FAO. https://doi.org/10.4060/cb2431en
Herforth, A., Venkat, A., Bai, Y., Costlow, L., Holleman, C. & Masters, W.A. 2022. Methods and options to monitor the cost and affordability of a healthy diet globally. Background paper to The State of Food Security and Nutrition in the World 2022. FAO Agricultural Development Economics Working Paper, 22-03. Rome, FAO. https://doi.org/10.4060/cc1169en
Bai, Y., Conti, V., Ebel, A., Cafiero, C., Herforth, A., Rissanen, M.O., Rosero Moncayo, J. & Masters, W.A. (forthcoming). Methods for monitoring the cost of a healthy diet based on price data from the International Comparison Program. FAO Statistics Division Working Paper. Rome, FAO.
无力负担健康膳食
定义:无力负担健康膳食定义为家庭或个人在扣除了用以购置食品外所有必需品的收入后,无力以最低价格组合购买满足健康膳食要求的当地可得食物。
报告方式:“无力负担发生率”(简称PUA)是估计一个人口群体中,除去获取所有非食品基本商品和服务所需收入后,可支配收入低于健康膳食最低成本的百分比。各国估计值的计算方法是,将各国健康膳食的成本与相关非食品基本需求的成本(r)相加得到的一个阈值,然后将该国收入分布与该阈值(n)进行比较。除了计算PUA外,还将PUA乘以相关人口规模,计算出无力负担健康膳食的人数(NUA)。
全系列(2017-2022年)PUA和NUA估计值会在每期新版报告中修订,以反映新的成本数据、人口数据和收入分布。由于修订过程通常意味着对整个PUA和NUA估计值系列进行回溯修订,建议读者不要比较不同期报告中的估计值,而应始终参考当前的报告,包括查阅过去年份的数据。
计算方法:为了估计一个人群中的PUA,我们为每个国家计算了每天人均成本阈值。由于缺乏用以确定特定国家非食品基本商品和服务成本的信息,非食品支出的差异基于世界银行对各国收入的四个分组。因此,每天人均成本阈值综合了一个国家的健康膳食成本和该国所属收入组别的非食品基本需求成本。最终的成本阈值确定方法如下:

其中,ci是一个国家的健康膳食成本,nj是国家所属收入组j的非食品基本成本。最终的成本阈值ni以2017年购买力平价(PPP)美元表示,通过将世界银行国际贫困线乘以每个收入组用于非食品基本商品和服务的总支出的比例进行计算,如下所示:


收入中用于非食品商品和服务的比例报告自低收入国家和中等偏下收入国家属于收入分布第二五分位数的家庭,以及中等偏上收入国家和高收入国家属于第一五分位数的家庭。这些比例来源于世界银行汇编的最新家庭调查,其中包括属于不同收入组的71个国家的实际消费信息(见第2章补充材料)。
最后,成本阈值ri与反映家庭可支配收入的特定国家收入分布xi进行比较,以估计收入低于该阈值的人口百分比,如下公式所示:

数据来源:收入分布由世界银行贫困与不平等数据平台提供,截至2022年约有150个国家有数据可查。14
区域和全球无力负担发生率汇总数据通过计算有数据国家的PUA估计值的人口加权平均值获得,如下所示:

其中,a表示区域或其他汇总值,PUAi是汇总中某国i的PUA估计值,Ni是相应的人口规模。只有有估计值国家至少覆盖总人口50%时,才会进行区域汇总。
计算无力负担健康膳食的人数(NUAa),是将平均PUAa(根据有数据国家计算)乘以该汇总所涉全部国家总人口规模Na。

科摩罗和中国台湾省仅有2017年和2021年无力负担情况的数据。因此,我们使用线性插值来估计2018年、2019年和2020年的值,并将2021年的值应用于2022年。南苏丹和阿拉伯叙利亚共和国只有2021年的数据,因此,我们用2021年的值计算所有其他年份的汇总数据。黎巴嫩2020年的值用于2017年、2018年和2019年,这些年份信息缺失。计算全球NUA值,是将全球五大区之一的PUA值乘以每个区的总人口规模。应避免将全球NUA估计值看作其他国家组(如基于收入水平的组)NUA估计值之和。人口数据取自2022年版《世界人口展望》。5
挑战和限制:在本报告中,我们对计算方法进行了改进,因为非食品需求的成本在不同国家之间是不同的。然而,由于缺乏具体到国家的信息,非食品支出的差异是按收入组而不是按国家纳入的。此外,除了需要通过校正来调整不同国家之间的差异之外,另一个重要方面是认识到每个国家内部实现最低限度体面生活标准的成本也各不相同。特别是对于大国和多样化的国家,如果不考虑这些差异,而是使用设定在国家平均水平的成本阈值,可能会导致负担能力的估计偏差。偏差的方向和程度取决于收入水平与正确的、特定地点的阈值之间可能存在的关联的方向和大小。
推荐阅读:
Bai, Y., Herforth, A., Cafiero C., Conti V., Rissanen, M.O., Masters, W.A & Rosero Moncayo, J. (forthcoming). Methods for monitoring the affordability of a healthy diet. FAO Statistics Division Working Paper. Rome, FAO.
Herforth, A., Bai, Y., Venkat, A., Mahrt, K., Ebel, A. & Masters, W.A. 2020. Cost and affordability of healthy diets across and within countries. Background paper for The State of Food Security and Nutrition in the World 2020. FAO Agricultural Development Economics Technical Study, No. 9. Rome, FAO. https://doi.org/10.4060/cb2431en
五岁以下儿童消瘦情况
定义:身高/身长(厘米)别体重低于世卫组织儿童生长标准中位数2个标准差(-2SD)。
报告方式:这是0至59个月大的儿童中,体重相对于身高低于世卫组织儿童生长标准中位数2个标准差(-2SD)的百分比。区域和全球汇总数据基于《儿童营养不良水平和趋势:联合国儿童基金会/世界卫生组织/世界银行集团儿童营养不良联合估计 — 2023年版主要发现》。每当发布主要发现新版本时,整个估计值系列都会进行修订,建议读者不要将区域和全球系列数据与报告的早期版本进行比较。国家层面的估计值基于2023年11月联合国儿童基金会/世卫组织/世界银行儿童营养不良联合估算数据集。
计算方法:
国家层面
儿童营养不良联合估计(JME)数据集包含了点估计值,并在可能时包括标准误差、95%置信区间和未加权样本大小。如有微观数据,JME数据集使用经过重新计算的估计值,以符合全球标准定义。如果没有微观数据,则使用被报告的估计值,除非因为以下原因需要进行调整以实现标准化:
- 使用2006年世卫组织儿童生长标准的替代生长参考标准;
- 年龄范围不包括完整的0-59个月年龄组;
- 数据来源仅对居住在农村地区的人口具有全国代表性。
区域和全球汇总
我们利用JME的2023年3月数据集中来自国家数据源的消瘦发生率数据,使用JME次区域多级模型,并应用2022年版《世界人口展望》中五岁以下儿童的人口权重,生成了1990年至2022年的区域和全球估计值。5
数据来源:具有全国代表性的家庭调查,例如人口与健康调查(DHS)、多指标类集调查(MICS)、救济和过渡标准化监测与评估(SMART)调查,以及生活水平测量研究(LSMS)调查是最常见的收集五岁以下儿童身高、体重和年龄的具有全国代表性的数据来源,这些数据可用于估计消瘦在国家层面的发生率。在人口覆盖率高的情况下,还包括一些行政数据来源(例如来自监测系统的数据)。
鉴于国家调查可以在任何季节进行,调查时儿童消瘦的发生率可能处于高位或低位;有时,如果数据收集跨越几个季节,该发生率可能介于高位和低位之间。因此,消瘦的发生率只是捕捉了特定时间点的消瘦情况,而不是一整年的情况。不同调查的季节变化使得我们很难对趋势作出推断。
挑战和限制:建议各国每三到五年报告一次消瘦情况;然而,一些国家收集数据的频率较低。尽管已尽一切努力使得统计数据在各国之间和时间上具有可比性,但各国数据在收集方法、人口覆盖和估算方法方面可能存在差异。由于抽样误差和非抽样误差(技术测量误差、记录误差等),调查中的估计值具有一定不确定性。在推算国家、区域和全球层面的估计值时,这两种误差来源都没有完全考虑在内。
推荐阅读:
de Onis, M., Blössner, M., Borghi, E., Morris, R. & Frongillo, E.A. 2004. Methodology for estimating regional and global trends of child malnutrition. International Journal of Epidemiology, 33(6): 1260–1270. https://doi.org/10.1093/ije/dyh202
UNICEF, WHO & World Bank. 2021. Technical notes from the background document for country consultations on the 2021 edition of the UNICEF-WHO-World Bank Joint Malnutrition Estimates. SDG Indicators 2.2.1 on stunting, 2.2.2a on wasting and 2.2.2b on overweight. New York, USA, UNICEF. data.unicef.org/resources/jme-2021-country-consultations
UNICEF, WHO & World Bank. 2023. Levels and trends in child malnutrition. UNICEF / WHO / World Bank Group Joint Child Malnutrition Estimates – Key findings of the 2023 edition. New York, USA, UNICEF, Geneva, Switzerland, WHO and Washington, DC, World Bank. https://data.unicef.org/resources/jme-report-2023, http://www.who.int/teams/nutrition-and-food-safety/monitoring-nutritional-status-and-food-safety-and-events/joint-child-malnutrition-estimates, https://datatopics.worldbank.org/child-malnutrition
WHO. 2014. Comprehensive Implementation Plan on maternal, infant and young child nutrition. Geneva, Switzerland. https://www.who.int/publications/i/item/WHO-NMH-NHD-14.1
WHO. 2024. Nutrition Landscape Information System (NLIS) country profile indicators: interpretation guide. Second edition. Geneva, Switzerland. https://www.who.int/publications/i/item/9789241516952
五岁以下儿童发育迟缓
定义:发育迟缓定义为年龄(天)别身高/身长(厘米)低于世卫组织儿童生长标准中位数2个标准差(-2SD)。
报告方式:这是0至59个月大的儿童中,身高相对于年龄低于世卫组织儿童生长标准中位数2个标准差(-2SD)的百分比。所呈现的估计值基于报告《儿童营养不良水平和趋势:联合国儿童基金会/世界卫生组织/世界银行集团儿童营养不良联合估计 — 2023年版主要发现》。每当有新版本主要发现发布时,整个估计值系列都会进行修订,建议读者不要将该估计值系列与报告的早期版本进行比较。
计算方法:
国家层面
儿童营养不良联合估计(JME)数据集包含了点估计值,如有可能,也包括标准误差、95%置信区间和未加权样本大小。如有微观数据可用,则JME数据集包含经重新计算的估计值,以符合全球标准定义。如没有微观数据,则呈现被报告的估计值,除非因以下原因需要进行调整以实现标准化:
- 使用2006年世卫组织儿童生长标准的替代生长参考标准;
- 年龄范围不包括完整的0–59个月年龄组;
- 数据来源仅对居住在农村地区的人口具有全国代表性。
基于2023年3月的JME数据集,发育迟缓的发生率是使用带有异质误差项的惩罚性纵向混合模型在logit尺度上建模的。模型的质量是通过模型拟合标准来量化的,该标准旨在平衡模型复杂度与被观察数据的拟合度。该建议方法具有重要特征,包括非线性时间趋势、区域趋势、特定国家趋势、协变量数据和异质误差项。所有有数据的国家都有助于估计总体时间趋势和协变量数据对发生率的影响。协变量数据包括线性和二次社会人口指数(SDI)bn、过去五年卫生系统平均可及性,以及数据来源类型。
2023年JME发布了2000年至2022年期间159个国家的年度国家层面模型估计值,这些国家至少在JME国家数据集中有一个数据点(例如来自家庭调查)。还为另外46个国家制作了模型估计值,仅用于生成区域和全球汇总。没有显示这46个国家的模型估计值,因为这些国家在JME数据集中没有任何家庭调查。不确定性区间对于监测趋势非常重要,特别是对于数据稀疏的国家和主要数据来源存在较大抽样误差的地方。当最近时期只有稀疏数据可用时,纳入一项调查可能会在预测曲线上引起重大变化。因此,需要使用不确定性区间,提高趋势解释性,反映预测的谨慎程度。估计的不确定性区间已经过测试和验证。
区域和全球汇总
2000年到2022年的全球和区域平均值计算方法是:以2022年各国五岁以下人口规模为权重,计算各国估计值的平均值。五岁以下人口规模基于2022年版《世界人口展望》,5该报告提供了205个国家和地区的模型估计值,其中包括JME国家数据集当中159个有国内数据(例如家庭调查)的国家,还包括46个为汇总区域和全球数据而生成模型估计值的国家,但没有显示这些国家的模型估计值,因为这些国家在JME国家数据集当中没有任何家庭调查。置信区间是基于自助法生成的。
数据来源:具有全国代表性的家庭调查(例如DHS、MICS、SMART调查和LSMS调查)是最常见的全国代表性数据来源,这些调查专门收集五岁以下儿童的身高和营养数据,可用于估计各国发育迟缓的发生率。在人口覆盖率高的地方,也包括了一些行政数据(例如来自监测系统的数据)。
挑战和限制:按照建议,各国每三到五年应报告一次发育迟缓情况,但一些国家的报告频率不足。尽管已尽力提高统计数据在各国之间以及和时间上的可比性,但各国数据在数据收集方法、人口覆盖和估计方法方面可能存在差异。由于抽样误差和非抽样误差(技术测量误差、记录误差等),调查的估计值带有不确定性。在推算国家、区域和全球层面的估计值时,这两种误差来源都没有完全考虑在内。
推荐阅读:
GBD 2019 Risk Factors Collaborators. 2020. Global burden of 87 risk factors in 204 countries and territories, 1990–2019: a systematic analysis for the Global Burden of Disease Study 2019. The Lancet, 396(10258): 1223–1249. https://doi.org/10.1016/s0140-6736(20)30752-2
McLain, A.C., Frongillo, E.A., Feng, J. & Borghi, E. 2019. Prediction intervals for penalized longitudinal models with multisource summary measures: An application to childhood malnutrition. Statistics in Medicine, 38(6): 1002–1012. https://doi.org/10.1002/sim.8024
UNICEF, WHO & World Bank. 2021. Technical notes from the background document for country consultations on the 2021 edition of the UNICEF-WHO-World Bank Joint Malnutrition Estimates. SDG Indicators 2.2.1 on stunting, 2.2.2a on wasting and 2.2.2b on overweight. New York, USA, UNICEF. data.unicef.org/resources/jme-2021-country-consultations
UNICEF, WHO & World Bank. 2023. Levels and trends in child malnutrition. UNICEF / WHO / World Bank Group Joint Child Malnutrition Estimates – Key findings of the 2023 edition. New York, USA, UNICEF, Geneva, Switzerland, WHO and Washington, DC, World Bank. https://data.unicef.org/resources/jme-report-2023, http://www.who.int/teams/nutrition-and-food-safety/monitoring-nutritional-status-and-food-safety-and-events/joint-child-malnutrition-estimates, https://datatopics.worldbank.org/child-malnutrition
WHO. 2014. Comprehensive Implementation Plan on maternal, infant and young child nutrition. Geneva, Switzerland. https://www.who.int/publications/i/item/WHO-NMH-NHD-14.1
WHO. 2024. Nutrition Landscape Information System (NLIS) country profile indicators: interpretation guide. Second edition. Geneva, Switzerland. https://www.who.int/publications/i/item/9789241516952
WHO & UNICEF. 2019. Recommendations for data collection, analysis and reporting on anthropometric indicators in children under 5 years old. Geneva, Switzerland and New York, USA. https://www.who.int/publications/i/item/9789241515559
五岁以下儿童超重
定义:身高/身长(厘米)别体重(公斤)大于世卫组织儿童生长标准中位数2个标准差(+2SD)。
报告方式:这是0至59个月大的儿童中,体重相对于身高高于世卫组织儿童生长标准中位数2个标准差(+2SD)的百分比。报告中呈现的估计值基于《儿童营养不良水平和趋势:联合国儿童基金会/世界卫生组织/世界银行集团儿童营养不良联合估计 — 2023年版主要发现》。每当主要发现发布新版本时,整个估计值系列都会进行修订,建议读者不要将当前估计值系列与报告的早期版本进行比较。
计算方法:
国家层面
儿童营养不良联合估计(JME)数据集包含了点估计值,如有可能,也包括标准误差、95%置信区间和未加权样本大小。如有微观数据可用,则JME数据集包含经重新计算的估计值,以符合全球标准定义。如没有微观数据,则呈现被报告的估计值,除非因以下原因需要进行调整以实现标准化:
- 使用2006年世卫组织儿童生长标准的替代生长参考标准;
- 年龄范围不包括完整的0–59个月年龄组;
- 数据来源仅对居住在农村地区的人口具有全国代表性。
基于2023年3月的JME数据集,超重的发生率是使用带有异质误差项的惩罚性纵向混合模型在logit(对数几率)尺度上建模的。模型的质量通过模型拟合标准进行量化,该标准旨在平衡模型复杂度与被观察数据的拟合度。该建议方法具有重要特征,包括非线性时间趋势、区域趋势、特定国家趋势、协变量数据和异质误差项。所有有数据的国家都有助于估计总体时间趋势和协变量数据对发生率的影响。协变量数据包括线性和二次社会人口指数(SDI)以及数据来源类型。
2000年至2022年各国超重情况的模型年度估计值由JME在2023年发布,涵盖160个国家,这些国家至少在JME国家数据集中包含一个数据点(例如来自家庭调查)。还为另外45个国家制作了模型估计值,仅用于生成区域和全球汇总。没有显示这45个国家的模型估计值,因为这些国家在JME数据集中没有任何家庭调查。不确定性区间对于监测趋势非常重要,特别是对于数据稀疏的国家和主要数据来源存在较大抽样误差的地方。当最近时期只有稀疏数据可用时,纳入一项调查可能会在预测轨迹上引起重大变化。因此,需要不确定性区间以提高趋势解释性、增加谨慎程度。估计的不确定性区间已经过测试和验证。
区域和全球汇总
1990年至2022年所有年份的全球和区域汇总计算方法是:以2022年各国五岁以下人口为权重,计算各国数值的平均值。五岁以下人口基于2022年版《世界人口展望》,5该报告提供了205个国家和地区的模型估计值。这包括160个有国家数据来源(例如家庭调查)被纳入JME国家数据集中的国家,还包括45个为汇总区域和全球数据而生成的模型估计值的国家,但没有显示这些国家的国家模型估计值,因为这些国家在JME国家数据集中没有任何家庭调查。置信区间是基于自助法生成的。
数据来源:具有全国代表性的家庭调查(例如DHS、MICS、SMART调查和LSMS调查)是最常见的具有全国代表性的数据来源,这些调查专门收集五岁以下儿童的身高、体重和营养数据,并可用于生成超重的国家层面发生率估计值。在人口覆盖率高的地方,也包括了一些行政数据(例如来自监测系统的数据)。
挑战和限制:按照建议,建议各国每三到五年应报告一次超重情况,但一些国家的报告频率不足。尽管已尽力提高统计数据在各国之间和时间上的可比性,但各国在数据收集方法、人口覆盖和估计方法方面可能存在差异。由于抽样误差和非抽样误差(技术测量误差、记录误差等),调查的估计值带有不确定性。在推算国家、区域和全球层面的估计值时,这两种误差来源都没有完全考虑在内。
推荐阅读:
GBD 2019 Risk Factors Collaborators. 2020. Global burden of 87 risk factors in 204 countries and territories, 1990–2019: a systematic analysis for the Global Burden of Disease Study 2019. The Lancet, 396(10258): 1223–1249. https://doi.org/10.1016/s0140-6736(20)30752-2
McLain, A.C., Frongillo, E.A., Feng, J. & Borghi, E. 2019. Prediction intervals for penalized longitudinal models with multisource summary measures: An application to childhood malnutrition. Statistics in Medicine, 38(6): 1002–1012. https://doi.org/10.1002/sim.8024
UNICEF, WHO & World Bank. 2021. Technical notes from the background document for country consultations on the 2021 edition of the UNICEF-WHO-World Bank Joint Malnutrition Estimates. SDG Indicators 2.2.1 on stunting, 2.2.2a on wasting and 2.2.2b on overweight. New York, USA, UNICEF. data.unicef.org/resources/jme-2021-country-consultations
UNICEF, WHO & World Bank. 2023. Levels and trends in child malnutrition. UNICEF / WHO / World Bank Group Joint Child Malnutrition Estimates – Key findings of the 2023 edition. New York, USA, UNICEF, Geneva, Switzerland, WHO and Washington, DC, World Bank. https://data.unicef.org/resources/jme-report-2023, http://www.who.int/teams/nutrition-and-food-safety/monitoring-nutritional-status-and-food-safety-and-events/joint-child-malnutrition-estimates, https://datatopics.worldbank.org/child-malnutrition
WHO. 2014. Comprehensive Implementation Plan on maternal, infant and young child nutrition. Geneva, Switzerland. https://www.who.int/publications/i/item/WHO-NMH-NHD-14.1
WHO. 2024. Nutrition Landscape Information System (NLIS) country profile indicators: interpretation guide. Second edition. Geneva, Switzerland. https://www.who.int/publications/i/item/9789241516952
WHO & UNICEF. 2019. Recommendations for data collection, analysis and reporting on anthropometric indicators in children under 5 years old. Geneva, Switzerland and New York, USA. https://www.who.int/publications/i/item/9789241515559
纯母乳喂养
定义:六个月以下婴儿的纯母乳喂养定义为只接受母乳,不外加任何食物或饮料,甚至不被喂水。
报告方式:这是在调查前24小时内,0至5个月大的婴儿仅以母乳为食,不加任何其他食物或饮料,甚至不被喂水的百分比。
报告呈现的估计值来自联合国儿童基金会。2024。婴幼儿喂养。参见:联合国儿童基金会。[2024年7月24日引用]。https://data.unicef.org/topic/nutrition/infant-and-young-child-feeding
计算方法:
国家层面
这一指标定义为不添加任何其他食物或饮料的母乳喂养,甚至不包括喂水。估计值基于对前一天喂养情况的回忆,涵盖0至5个月大的婴儿。

奶妈喂养、挤出的母乳喂养和捐赠的母乳喂养都算作母乳喂养。处方药物、口服补液溶液、维生素和矿物质不计为液体或食物。然而,草药液体和类似的传统药物视为液体,消费这些的婴儿不算作纯母乳喂养。
区域和全球汇总
2012年的区域和全球纯母乳喂养估计值是使用2005年至2012年期间每个国家的最新估计值生成的。同样,2022年的估计值是使用2016年至2022年期间每个国家的最新估计值生成的。全球和区域估计值是作为每个国家纯母乳喂养的发生率作为加权平均数计算出来的,以2022年版《世界人口展望》中0至5个月大婴儿的总数(定义为零岁人口的一半)为权重。5只有在已有数据至少代表相应区域0至5个月大婴儿总数50%的情况下报告才呈现估计值,除非另有说明。
数据来源:数据来自具有全国代表性的家庭调查如DHS和MICS。估计值基于调查前24小时内0至23个月大婴儿的液体和食物摄入量。
挑战和限制:虽然有较高比例的国家收集纯母乳喂养数据,但高收入国家尤其缺乏数据。根据建议,每三到五年应报告一次纯母乳喂养情况,但一些国家的报告频率较低,这意味着喂养模式的变化通常在变化发生后几年才被检测到。
区域和全球平均水平可能会受到本报告所涉期间哪些国家有数据的影响。
使用前一天的喂养作为依据可能会导致纯母乳喂养的婴儿比例高估,因为一些婴儿可能被不定期喂食其他液体或食物,但在调查前一天没有喂食。
推荐阅读:
UNICEF. 2024. Infant and young child feeding. In: UNICEF. [Cited 24 July 2024]. https://data.unicef.org/topic/nutrition/infant-and-young-child-feeding
WHO. 2014. Comprehensive implementation plan on maternal, infant and young child nutrition. Geneva, Switzerland. https://www.who.int/publications/i/item/WHO-NMH-NHD-14.1
WHO. 2024. Nutrition Landscape Information System (NLIS) country profile indicators: interpretation guide. Second edition. Geneva, Switzerland. https://www.who.int/publications/i/item/9789241516952
WHO & UNICEF. 2021. Indicators for assessing infant and young child feeding practices: definitions and measurement methods. Geneva, Switzerland, and New York, USA. https://www.who.int/publications/i/item/9789240018389
低出生体重
定义:低出生体重定义为出生时体重低于2500克。
报告方式:这是出生时体重低于2500克的新生儿百分比。报告呈现的估计值来自联合国儿童基金会和世卫组织2023年版《低出生体重联合估计》。鉴于新版本都会对整个估计值系列进行修订,建议读者不要与以前的版本进行比较。
计算方法:
国家层面
本报告从158个国家收集了2000年到2020年包括调查数据和行政数据在内的具有全国代表性的低出生体重数据。之后应用数据质量标准和调整方法,形成最终的国家数据集,并将这些数据纳入建模过程。在将国家数据输入数据集之前,对其进行了覆盖和质量审查,并进行调整,以解决因出生体重缺失和数据堆积造成的偏差。要纳入来自行政数据的出生体重数据,相关数据需要至少覆盖2022年版《世界人口展望》5估计的当年活产儿的80%。要纳入国家家庭调查数据集,调查数据必须符合以下条件:
- 调查数据至少有30%的样本有出生体重;
- 调查数据中至少有200个出生体重;
- 没有严重的数据堆积或不可信的数据分布,这意味着:(1)所有出生体重中,至多55%落在三个最常见的出生体重上(例如,如果3000克、3500克和2500克是三个最常见的出生体重,则三者加起来必须占调查数据中所有出生体重的至多55%);(2)所有出生体重中,至多10% ≥ 4500克;(3)位于出生体重两端(即 < 500克或 > 5000克)的出生体重至多5%;
- 经过了对缺失出生体重和堆积的调整。
本报告使用贝叶斯多层次回归模型预测了国家层面的低出生体重发生率,在logit(对数几率)尺度上进行模型拟合,以确保比例在0和1之间,然后进行反向转换,并乘以100以获得发生率估计值。
层次随机特定国家截距(全球范围各区域内国家)解释了区域内和区域间的相关性。在时间序列上使用了惩罚样条作为时间平滑处理,这意味着可捕捉国家层面的非线性时间趋势,而没有让随机变化影响到趋势。模型中包括的最终协变量有:人均国民总收入购买力平价,bo成年女性体重不足的发生率,成年女性识字率,现代避孕方法普及率和城市人口占比。
本报告通过数据质量类别来应用偏差偏移和额外的方差项。这些偏差偏移应用于来自较低质量类别的行政数据,这近似于调查数据调整中已经考虑的堆积预期偏差。额外的方差基于行政数据的质量类别;如果有国家既有行政数据又有调查数据,则基于行政和调查数据之间的加权。
本报告进行了标准诊断检查,以评估收敛性和抽样效率;实施了交叉验证,平均使用20%测试数据和80%训练数据进行了超过200个随机分割;进行了敏感性分析,包括对协变量、偏差方法、时间平滑和非信息性先验的检查。所有模型都使用R统计软件和rjags以及R2jags包进行拟合。15, 16
该模型包括所有符合纳入标准的2040个国家-年次数据,并为195个有低出生体重输入数据或协变量数据的国家和地区生成了2000年至2020年的年度估计值,具有95%的可信区间。本报告仅呈现了有数据的国家和地区的估计值。对于195个国家中的37个(没有数据或数据不符合纳入标准)的国家,最终模型用来基于区域和国家层面的协变量,估计国家截距和时间趋势,预测低出生体重的发生率。
区域和全球汇总
本报告利用所有195个国家和地区的所有估计值,通过2022年版《世界人口展望》估计的当年活产儿数量加权,生成了区域和全球汇总。5
数据来源:可以从众多数据来源中得出具有全国代表性的低出生体重发生率估计值,这些来源广义上包括国家行政数据或代表性家庭调查。国家行政数据来自包括民事登记和生命统计系统、国家卫生管理信息系统和出生登记在内的国家系统。国家的家庭调查,如包含出生体重信息以及关键相关指标(包括母亲对出生时大小的感知)的DHS和MICS调查,也是低出生体重数据的重要来源,特别是在出生体重没有记录和/或数据堆积成问题的背景下。
挑战和限制:在全球监测低出生体重的一个主要限制,是世界上许多儿童缺少出生体重数据。与较富裕、受教育程度较高的城市母亲和家庭相比,出生在贫穷农村地区和家庭、母亲受教育程度较低的儿童更不可能有出生体重记录。几乎有三分之一包含出生体重数据的调查没有被纳入最终分析,主要是由于数据缺失或质量差,这些数据主要来自低收入国家的高风险低出生体重区域。
由于缺少出生体重信息的新生儿具有低出生体重带来的危险因素,不包括这些儿童的估计值可能低于真实值。此外,低收入和中等收入国家的数据存在较大数据质量问题,即在500克或100克的倍数上过度堆积,这可能会进一步低估低出生体重。当前数据库中应用的对调查估计值中缺失出生体重和数据堆积的情况进行修正的方法就旨在解决这个问题。但当前方法的一个限制是,行政数据中没有个人数据,且这些数据不能通过直接修正以去除堆积和缺失造成的偏差。
建模中使用的地理分组可能不适用于流行病学或经济区域异常值。总的来说,195个国家中有37个(没有输入数据)的估计值可能受到影响。此外,鉴于大约一半的建模国家对于每次自助法预测都随机生成了对特定国家的积极或消极效应,区域和全球估计值的置信限可能人为地小,使得区域和全球层面的相对不确定性小于国家层面。
推荐阅读:
Blanc, A. & Wardlaw, T. 2005. Monitoring low birth weight: An evaluation of international estimates and an updated estimation procedure. Bulletin World Health Organization, 83(3): 178–185. https://www.ncbi.nlm.nih.gov/pmc/articles/PMC2624216
Chang, K.T., Carter, E.D., Mullany, L.C., Khatry, S.K., Cousens, S., An, X., Krasevec, J. et al. 2022. Validation of MINORMIX approach for estimation of low birthweight prevalence using a rural Nepal dataset. The Journal of Nutrition, 152(3): 872–879. https://doi.org/10.1093/jn/nxab417
Okwaraji, Y.B., Krasevec, J., Bradley, E., Conkle, J., Stevens, G.A., Gatica-Domínguez, G., Ohuma, E.O. et al. 2024. National, regional, and global estimates of low birthweight in 2020, with trends from 2000: a systematic analysis. The Lancet, 403(10431): 1071–1080. https://doi.org/10.1016/S0140-6736(23)01198-4
UNICEF & WHO. 2023. Low birthweight. In: UNICEF. [Cited 24 July 2024]. https://data.unicef.org/topic/nutrition/low-birthweight
UNICEF & WHO. 2023. Joint low birthweight estimates. In: WHO. [Cited 24 July 2024]. https://www.who.int/teams/nutrition-and-food-safety/monitoring-nutritional-status-and-food-safety-and-events/joint-low-birthweight-estimates
成人肥胖
定义:体重指数(BMI) ≥ 30.0kg/m2。BMI是常用的体重与身高比,用于区分成年人的营养状况。BMI是按公斤计算的体重除以身高(米)的平方(kg/m2)。肥胖患者包括BMI等于或高于30 kg/m2的个体。
报告方式:18岁以上人群的BMI ≥ 30.0kg/m2的百分比,按性别加权并按年龄标准化。报告呈现的估计值基于世卫组织。2024。全球卫生观测站(GHO)数据库:成人肥胖的发生率,BMI ≥ 30,年龄标准化。按国家估计。[2024年7月24日访问]。https://www.who.int/data/gho/data/indicators/indicator-details/GHO/prevalence-of-obesity-among-adults-bmi-=-30-(age-standardized-estimate)-(-)。许可:CC-BY-4.0。
鉴于每个新版本都会对整个估计值系列进行修订,建议读者不要将当前估计值系列与以前的版本进行比较。
计算方法:
国家层面
本报告应用了贝叶斯分层回归模型,使用马尔可夫链蒙特卡洛(MCMC)样本拟合,并使用后验MCMC样本进行推断,以估计从1990年到2022年不同BMI类别的发生趋势,按性别、年龄、国家和年份分类,主要基于地理位置和国家收入,将国家划分为20个区域和8个超级区域。该模型具有分层结构,即每个国家和年份的估计值参考自身的数据(如有),或参考同一国家其他年份的数据或同一区域和超级区域其他国家的数据,特别是那些在相似时间段内有数据国家的数据。模型包括通过线性和二阶随机游走项的组合来表示非线性时间趋势,所有这些项都以分层方式建模。本报告使用三次样条曲线对BMI的年龄关联进行建模,以允许非线性年龄模式,该模式可能因国家而异。样条曲线的系数以分层方式建模,并允许随时间变化以反映不断变化的年龄关联。通过使用世卫组织标准人口的年龄权重,对特定的年龄-性别估计值进行加权平均,执行了年龄标准化。17
区域和全球汇总
全球和区域的估计发生率是成员国家的人口加权平均值。
数据来源:大多数监测成人肥胖的数据来自基于人口的研究,这些研究对身高和体重进行了测量,如具有全国代表性的家庭调查。
挑战和限制:体重指数(BMI)是衡量体脂程度和分布的不完美指标,但在基于人口的调查中广泛使用,并在临床实践中使用;它还与更复杂、成本更高的双能X线吸收法相关。
一些国家的数据很少,三个国家没有数据。这些国家的估计值在较大程度上是通过地理层级参照其他国家的数据估算的。
不同年龄组的数据也存在差异,老年人(65岁及以上)的数据较少,这增加了该年龄组估计值的不确定性。
推荐阅读:
Ahmad, O.B., Boschi-Pinto, C., Lopez, A.D., Murray, C.J., Lozano, R. & Inoue, M. 2001. Age standardization of rates: A new WHO standard. GPE Discussion Paper Series 31. Geneva, Switzerland, WHO. https://cdn.who.int/media/docs/default-source/gho-documents/global-health-estimates/gpe_discussion_paper_series_paper31_2001_age_standardization_rates.pdf
NCD-RisC (NCD Risk Factor Collaboration). 2024. Worldwide trends in underweight and obesity from 1990 to 2022: a pooled analysis of 3663 population-representative studies with 222 million children, adolescents, and adults. The Lancet, 403(10431): 1027–1050. https://doi.org/10.1016/S0140-6736(23)02750-2
Sixty-Sixth World Health Assembly. 2013. Follow-up to the Political Declaration of the High-level Meeting of the General Assembly on the Prevention and Control of Non-communicable Diseases. https://apps.who.int/gb/ebwha/pdf_files/WHA66/A66_R10-en.pdf?ua=1
WHO. 2022. Updated Appendix 3 of the WHO Global NCD Action Plan 2013-2030. Technical Annex (version dated 26 December 2022). Geneva, Switzerland. https://cdn.who.int/media/docs/default-source/ncds/mnd/2022-app3-technical-annex-v26jan2023.pdf?sfvrsn=62581aa3_5
WHO. 2024. Noncommunicable Diseases Data Portal. In: WHO. [Cited 8 April 2024]. https://ncdportal.org
WHO. 2024. Nutrition Landscape Information System (NLIS) country profile indicators: interpretation guide. Second edition. Geneva, Switzerland. https://www.who.int/publications/i/item/9789241516952
WHO. 2024. Global Health Observatory (GHO) data repository: Prevalence of obesity among adults, BMI ≥ 30, age-standardized. Estimates by country. [Accessed on 24 July 2024]. https://www.who.int/data/gho/data/indicators/indicator-details/GHO/prevalence-of-obesity-among-adults-bmi--30-(age-standardized-estimate)-(-). Licence: CC-BY-4.0.
15至49岁女性贫血发生率
定义:15至49岁非孕妇和非哺乳期女性的血红蛋白浓度低于120g/L,孕妇低于110g/L,根据海拔高度和吸烟情况进行调整。
报告方式:孕妇血红蛋白浓度低于110g/L,非孕妇低于120g/L的女性占比。报告呈现的估计值基于世卫组织。2021。《全球贫血估计》,2021年版。参见:世卫组织。[2024年7月24日引用]。 https://www.who.int/data/gho/data/themes/topics/anaemia_in_women_and_children
鉴于每次新版都会对整个估计值系列进行修订,建议读者不要将当前估计值系列与以前的版本进行比较。
计算方法:
国家层面
按怀孕状态分类的2021年版15至49岁女性的贫血估计值数据来源包括:微量营养素数据库,该数据库是世卫组织维生素和矿物质营养信息系统(VMNIS)的一部分;以及1995年至2019年的匿名个体数据。在相关情况下(即该国有高海拔人口)进行了血红蛋白浓度的海拔高度调整,并在可行的情况下进行了吸烟状况调整。排除了生物学上不合理的血红蛋白值(< 25g/L或 > 200g/L)。
使用贝叶斯分层混合模型估计血红蛋白分布,并系统地处理了缺失数据、非线性时间趋势和数据来源的代表性问题。简而言之,该模型根据每个国家的数据(如有)、同一国家其他年份的数据,以及在相似时间段内其他国家的数据,特别是同一区域其他国家的数据,计算每个国家每年的估计值。当数据不存在或信息量较弱时,该模型更多地借用数据,而对于数据丰富的国家/地区,则较少借用数据。生成的估计值还参考了有助于预测血红蛋白浓度的协变量(例如社会人口指数、肉类供应量[千卡/人]、女性的BMI均值和五岁以下儿童死亡率的对数)。不确定性范围(可信区间)反映了主要的不确定性来源,包括抽样误差、由于样本设计/测量问题导致的非抽样误差,以及为没有数据的国家/年份进行估计的不确定性。
区域和全球汇总
全球和区域的发生率估计值是成员国家的人口加权平均值。
数据来源:首选的数据来源是人口调查。在某些情况下,可能会使用监测系统的数据,但诊断记录通常会出现低估。世卫组织VMNIS的微量营养素数据库汇集并总结了各种其他资料中有关人群微量营养素状况的数据,包括从科学文献以及通过合作伙伴收集的数据,后者包括世卫组织区域和国别办事处、联合国组织、卫生部、研究和学术机构以及非政府组织。此外,还从多国调查中获得了匿名的个体数据,这些调查包括人口健康调查、疟疾指标调查和生殖健康调查。
挑战和限制:尽管有较高比例的国家有代表性的贫血情况调查数据,但在高收入国家中,关于这一指标的报告仍然不足。因此,估计值可能无法完全捕捉各国和区域之间的差异,从而在数据稀疏时趋向于“收缩”到全球平均水平。
推荐阅读:
Stevens, G.A., Paciorek, C.J., Flores-Urrutia, M.C., Borghi, E., Namaste, S., Wirth, J.P., Suchdev, P.S., Ezzati, M., Rohner, F., Flaxman, S.R. & Rogers, L.M. 2022. National, regional, and global estimates of anaemia by severity in women and children for 2000–19: a pooled analysis of population-representative data. The Lancet Global Health, 10(5): e627–e639. https://doi.org/10.1016/S2214-109X(22)00084-5
WHO. 2011. Haemoglobin concentrations for the diagnosis of anaemia and assessment of severity. Vitamin and Mineral Nutrition Information System. Geneva, Switzerland. https://apps.who.int/iris/bitstream/handle/10665/85839/WHO_NMH_NHD_MNM_11.1_eng.pdf
WHO. 2014. Comprehensive Implementation Plan on Maternal, Infant and Young Child Nutrition. Geneva, Switzerland. https://www.who.int/publications/i/item/WHO-NMH-NHD-14.1
WHO. 2021. WHO global anaemia estimates, 2021 edition. In: WHO. [Cited 24 July 2024]. https://www.who.int/data/gho/data/themes/topics/anaemia_in_women_and_children
WHO. 2021. Vitamin and Mineral Nutrition Information System (VMNIS). In: WHO. [Cited 20 April 2023]. https://www.who.int/teams/nutrition-and-food-safety/databases/vitamin-and-mineral-nutrition-information-system
WHO. 2024. Nutrition Landscape Information System (NLIS) Country Profile. In: WHO. [Cited 20 April 2023]. https://www.who.int/data/nutrition/nlis/country-profile
WHO. 2024. Nutrition Data Portal. In: WHO. [Cited 6 April 2024]. https://platform.who.int/nutrition/nutrition-portals


